MuJoCo シミュレーションによる閉ループ評価
実機環境での動作に先立ち、卓上マニピュレーションシミュレータを用いて ACT 推論パイプラインおよび整列精度の閉ループ検証を行う。
依存環境のセットアップ(ホスト環境)
source .venv/bin/activate
pip install -e "port_pick_align/[simulation,dev]"
# 学習済みチェックポイントの推論を行う場合は training 拡張も導入する
pip install -e "port_pick_align/[simulation,training,dev]"
オフスクリーン描画は標準の python インタプリタで実行可能である(mjpython は対話型 3D ビューアの起動時にのみ使用する)。グラフィクス描画バックエンドの指定が必要な環境では、以下の環境変数を設定する。
シミュレーション環境の構成
- 機構モデル: 6 自由度アームおよびグリッパ(関節名は
configs/contract.yamlと同一) - センサ構成: Top および Wrist の 2 眼カメラ(解像度 640×480)
- オブジェクト: 小型直方体箱および机上面の目標整列枠
- 実装パッケージ:
port_pick_align.simulation(モデル定義:simulation/assets/so101_tabletop.xml)
テーブル配置(2026-10-26 の正)
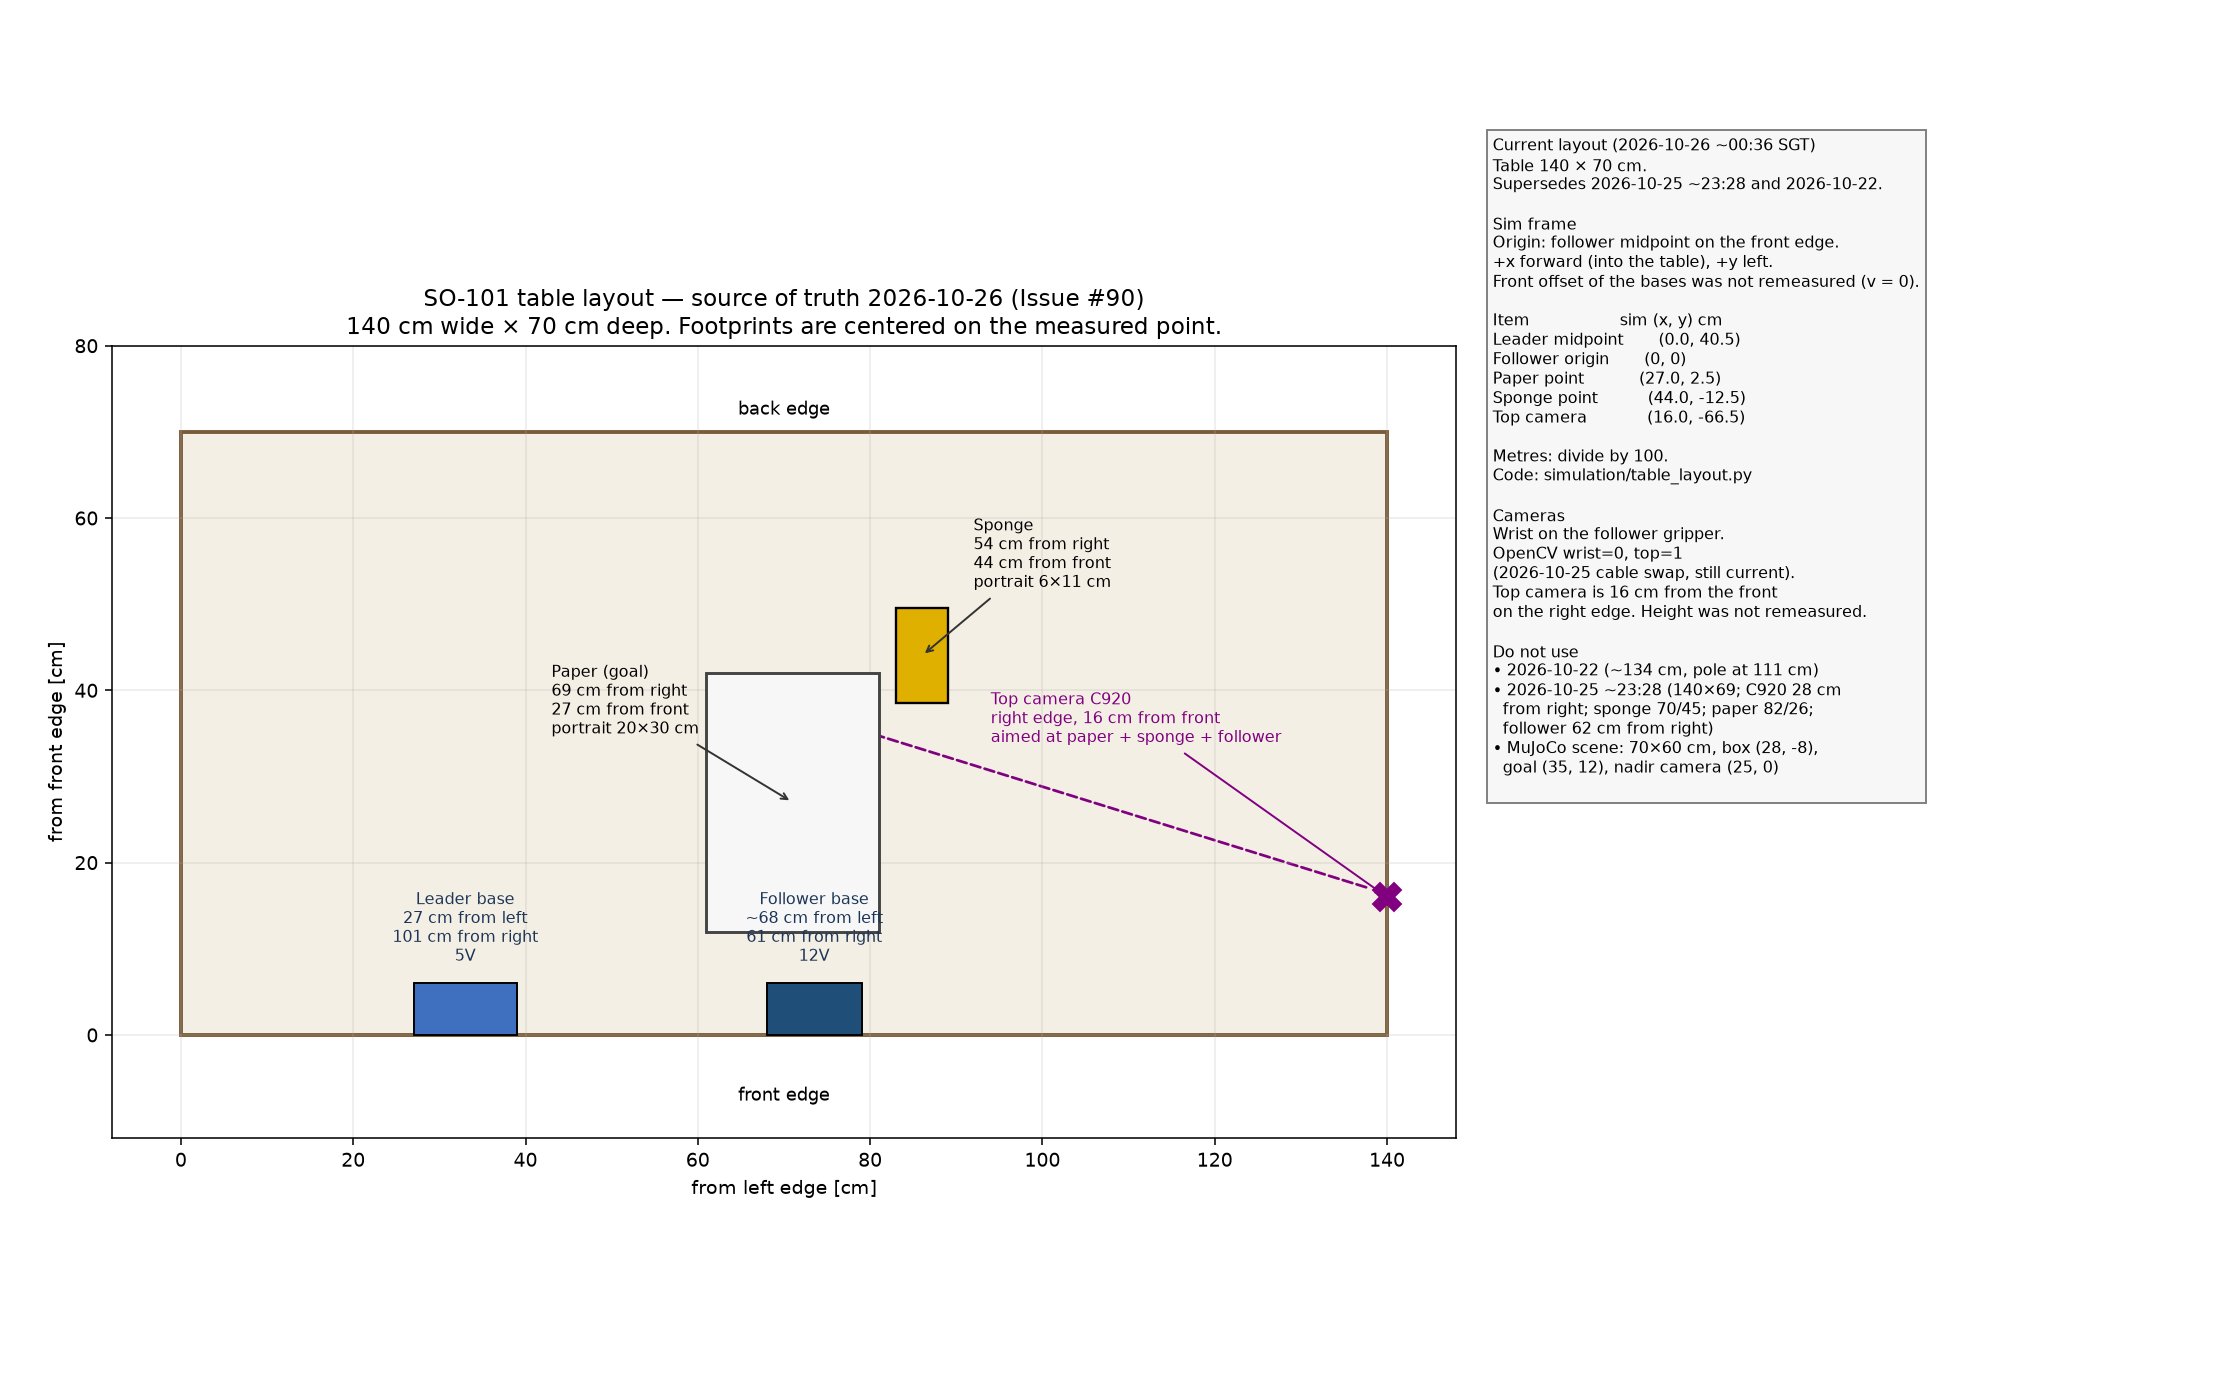
実機の bring-up と live eval はテーブル配置(140 × 70 cm)を正とする。Leader は左から 27 cm / 右から 101 cm。Follower は左から約 68 cm / 右から 61 cm。C920 は右端、手前から 16 cm。紙は右から 69 cm、手前から 27 cm(縦置き 20×30 cm)。スポンジは右から 54 cm、手前から 44 cm(縦置き 6×11 cm)。手首カメラは Follower のグリッパ。OpenCV は wrist 0、top 1。
この縁からの距離を sim 座標(Follower 中点を手前縁、+x 前方、+y 左)へ写すと次になる。
| 対象 | sim (x, y) m |
|---|---|
| Leader 中点 | (0, 0.405) |
| Follower 原点 | (0, 0) |
| 紙の実測点 | (0.27, 0.025) |
| スポンジの実測点 | (0.44, −0.125) |
| 上カメラ | (0.16, −0.665) |
写像と規約(基部の中点、手前縁を原点、実測点であり角とは書いていないこと)は table_layout.py と hardware.md にある。
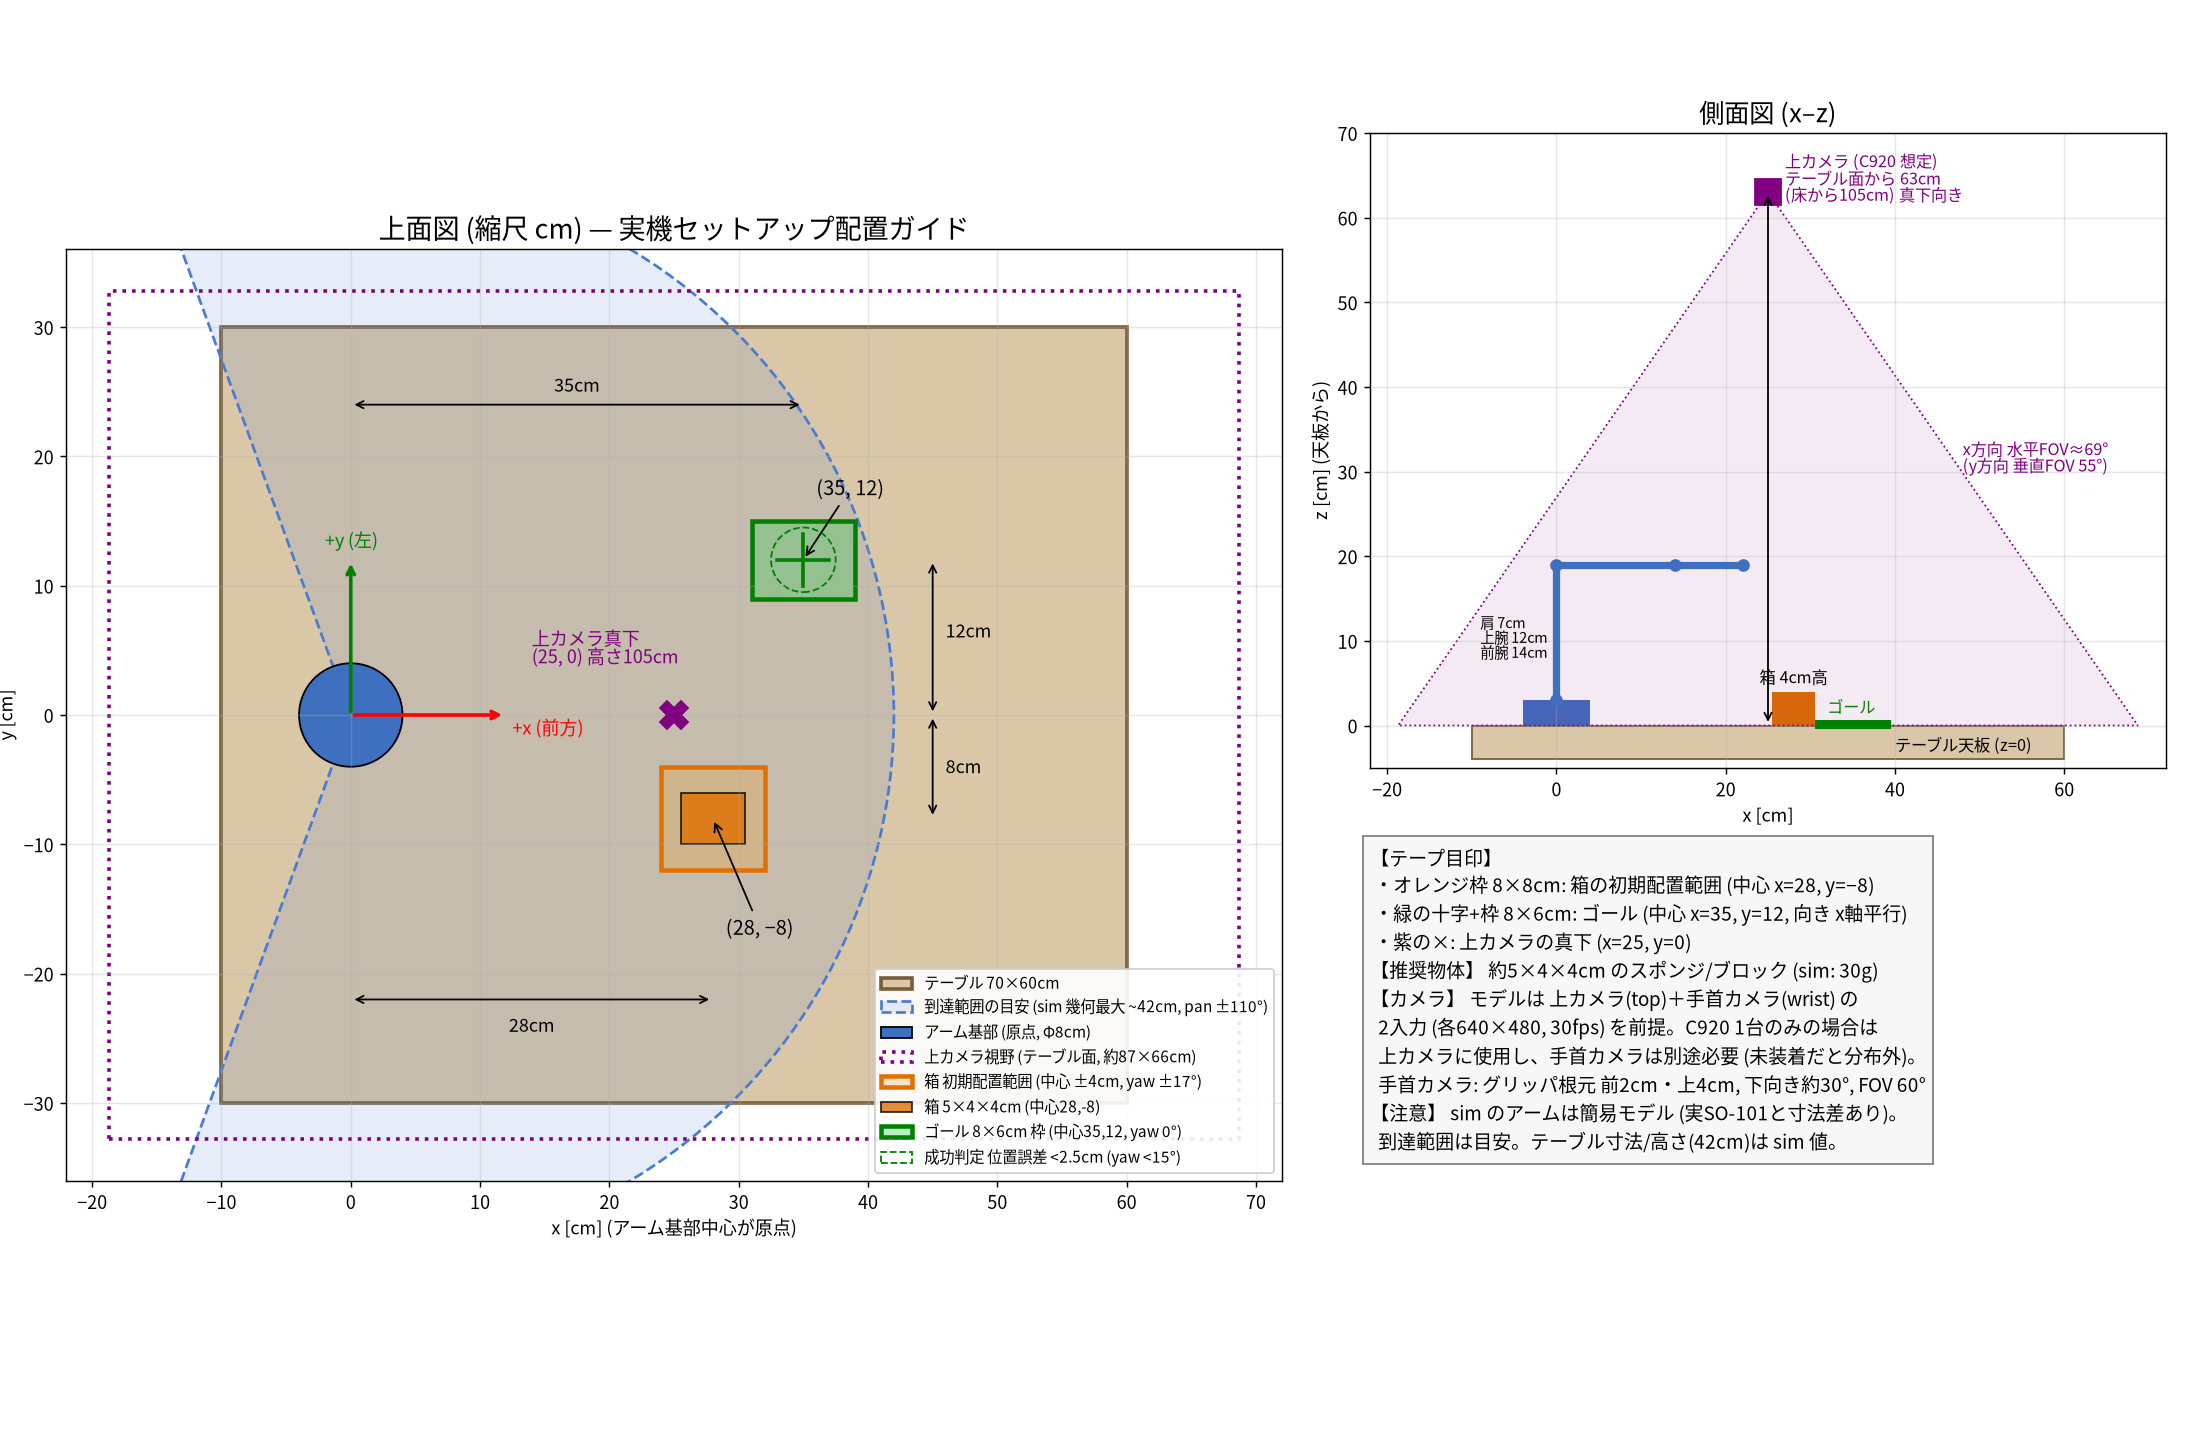
so101_tabletop.xml が読むのは廃止した簡易シーンである。テーブルはおよそ 70×60 cm、箱の初期位置 (0.28, -0.08) m、ゴール (0.35, 0.12) m、真下の上カメラ (0.25, 0, 1.05) m。現行の sim 評価はこのシーンのままなので、既存チェックポイントと比較できる。これらの geom を bring-up に写さない。古い図は so101_layout_guide_superseded_pre_20261026.png。現行の図は so101_layout_guide.png。XML には無く、同じく廃止: 2026-10-25 ~23:28(テーブル 140×69、C920 は右から 28 cm、スポンジ 70/45、紙 82/26、Follower は右から 62 cm)と 2026-10-22 の収録配置。
動作の可視化と確認
1. MuJoCo 対話型 3D ビューア
macOS 環境では、スレッド制約(launch_passive)のため mjpython を使用して起動する必要がある。uv で作成した仮想環境では、動的ライブラリへのシンボリックリンクを作成して実行する。
source .venv/bin/activate
# uv 製仮想環境における動的ライブラリの配置(初回のみ)
mkdir -p .venv/lib
ln -sfn "$(python -c 'import sysconfig; print(sysconfig.get_config_var("LIBDIR"))')/libpython3.12.dylib" \
  .venv/lib/libpython3.12.dylib

.venv/bin/mjpython scripts/view_sim.py --policy scripted
操作方法: マウスのドラッグ操作で視点回転、スクロールでズームを行う。ウィンドウを閉じると終了する。
2. Rerun によるマルチモーダル可視化
仮想環境内の rerun バイナリが実行可能パスに含まれていることを前提とする。
export PATH="$PWD/.venv/bin:$PATH"
python scripts/run_sim_eval.py --policy scripted --rerun --save-video
3. ロールアウト動画ファイルの確認
python scripts/run_sim_eval.py --policy scripted --save-video --no-rerun
open outputs/eval/sim_rollout.mp4   # macOS 環境での再生確認
ポリシー種別ごとの閉ループ評価コマンド
ポリシーの種別や実行環境に応じて、以下のコマンドを実行する。
# デモ用ヒューリスティックポリシー(固定スポーン位置における把持・整列動作の確認)
# 既定の --video-mode topdown は OpenGL 不要の俯瞰模式図動画を生成する
python scripts/run_sim_eval.py --policy scripted --save-video --no-rerun

# OpenGL / glfw が利用可能な環境におけるカメラ撮像動画の生成
python scripts/run_sim_eval.py --policy scripted --video-mode mujoco --save-video

# 最小依存関係による動作テスト(現在関節位置の繰り返し入力)
python scripts/run_sim_eval.py --policy mock --episodes 1 --max-steps 20 --no-save-video

# 学習済み ACT チェックポイントによる推論実行(入出力形状の疎通検証)
python scripts/run_sim_eval.py --policy checkpoint \
  --checkpoint checkpoints/synthetic_act/best_model.pt --video-mode topdown

# Phase 1.5 本評価。チェックポイントが無いときは失敗し、指標は作らない。
# 達成判定は n_action_steps=30(Temporal Ensembling なし)で、
# outputs/eval_sim_act/metrics.json に書く。TE は outputs/eval_sim_act_te/ の別指標。
# Mac では DEVICE=mps。未計測のプレースホルダは docs/results/eval_sim_act.pending.json。
DEVICE=mps ./scripts/run_phase15_benchmark.sh

# Rerun 可視化を有効化した閉ループ評価
export PATH="$PWD/.venv/bin:$PATH"
python scripts/run_sim_eval.py --policy scripted --rerun --video-mode mujoco
評価スクリプトの出力成果物(Git 管理対象外):
outputs/eval/metrics.json: 平面位置誤差、ヨー角誤差、把持および整列の成功率集計outputs/eval/sim_rollout.mp4: 視覚化ロールアウト動画
単体・統合テスト
mujoco パッケージが未インストールの環境では pytest.importorskip により自動的にテストがスキップされるため、最小構成の CI パイプラインを阻害しない。
Temporal Ensembling
ACT は各制御周期で未来のアクションチャンクをまとめて予測する。閉ループで常に最新チャンクの先頭要素だけを採用すると、予測の入れ替わりが関節指令の段差になる。CheckpointPolicy(temporal_ensemble=True) は、同一時刻に対する過去チャンクの予測をキューに保持し、Zhao et al. (2023) および LeRobot の ACTTemporalEnsembler に合わせて指数重みで平均する。重みは w_i = exp(-m * i) で、i = 0 が最も古い予測である。m > 0 では古い予測の比重が大きく、m = 0 は均一平均、m < 0 は新しい予測の比重が大きい。既定の m は 0.01 である。フラグを無効にするとチャンクはそのまま返る。
オラクル教示データの収集
同一環境と ScriptedPickAlignPolicy から LeRobotDataset を自動収集する手順は dataset.md に記載する。エントリポイントは scripts/collect_sim_dataset.py である。
関連文書
- 現行の実機テーブルと sim 座標: hardware.md、real_robot_bringup.md
- 評価 API 仕様: evaluation.md
- ACT モデルの訓練: training.md
- 教示データ収集: dataset.md